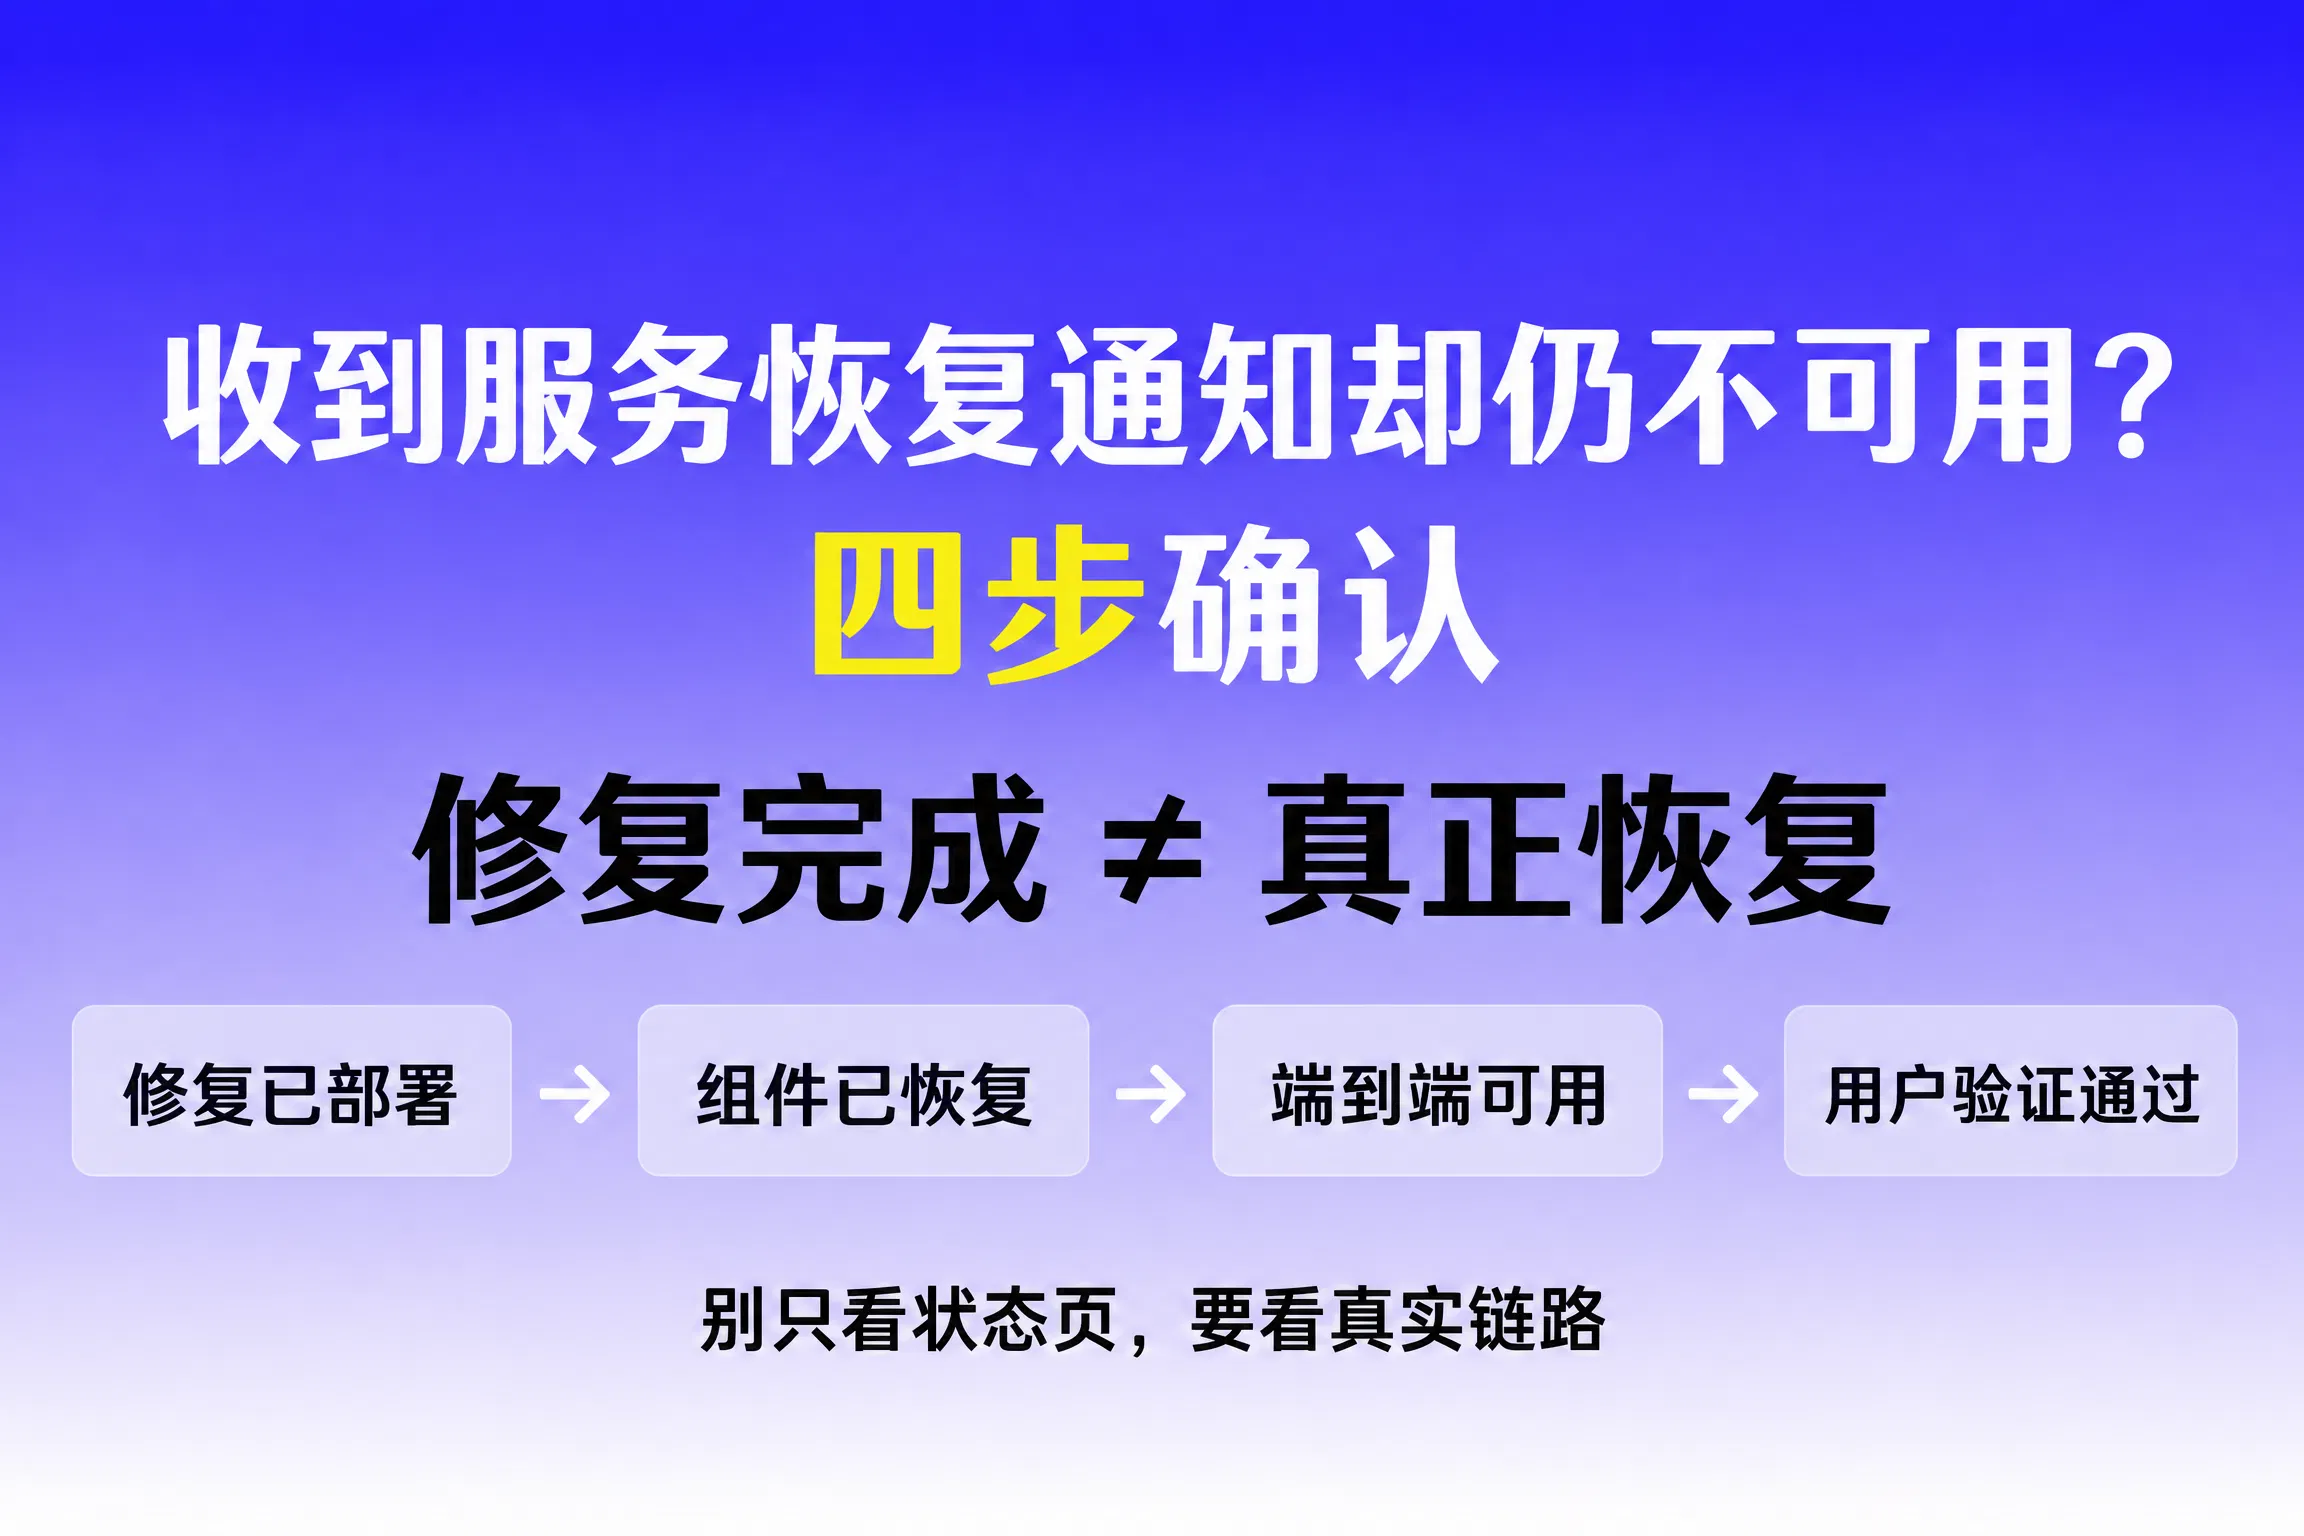
收到恢复通知后服务未好,是因为官方将技术修复等同于影响消失,却跳过了指标验证与用户观察等关键确认环节。
收到恢复通知后为什么服务还没好:修复≠影响消失
组件修复完成不代表用户侧影响立即消失,真正的服务恢复需经历执行、监控、抽样及观察四步完整流程方可确认。
你刚看到“服务已恢复”的公告,点进去却依旧报错。这种落差并非偶然,而是源于一个核心误区:把“组件修好了”直接等同于“用户没影响了”。
为什么“已修复”不等于“已恢复”
核心概念速览:为什么“修好了”≠“能用了”?
技术修复 (Technical Fix): 指工程师完成了代码回滚、重启容器或发布补丁。这是一个后台的“瞬时动作”。
服务恢复 (Service Recovery): 指缓存刷新完毕、流量完成切换,用户端的体验完全回归正常。这是一个需要时间的“过程”。
结论: 您收到通知却依然无法使用,是因为您正处于从“技术动作完成”到“业务全面生效”之间的时间差里。
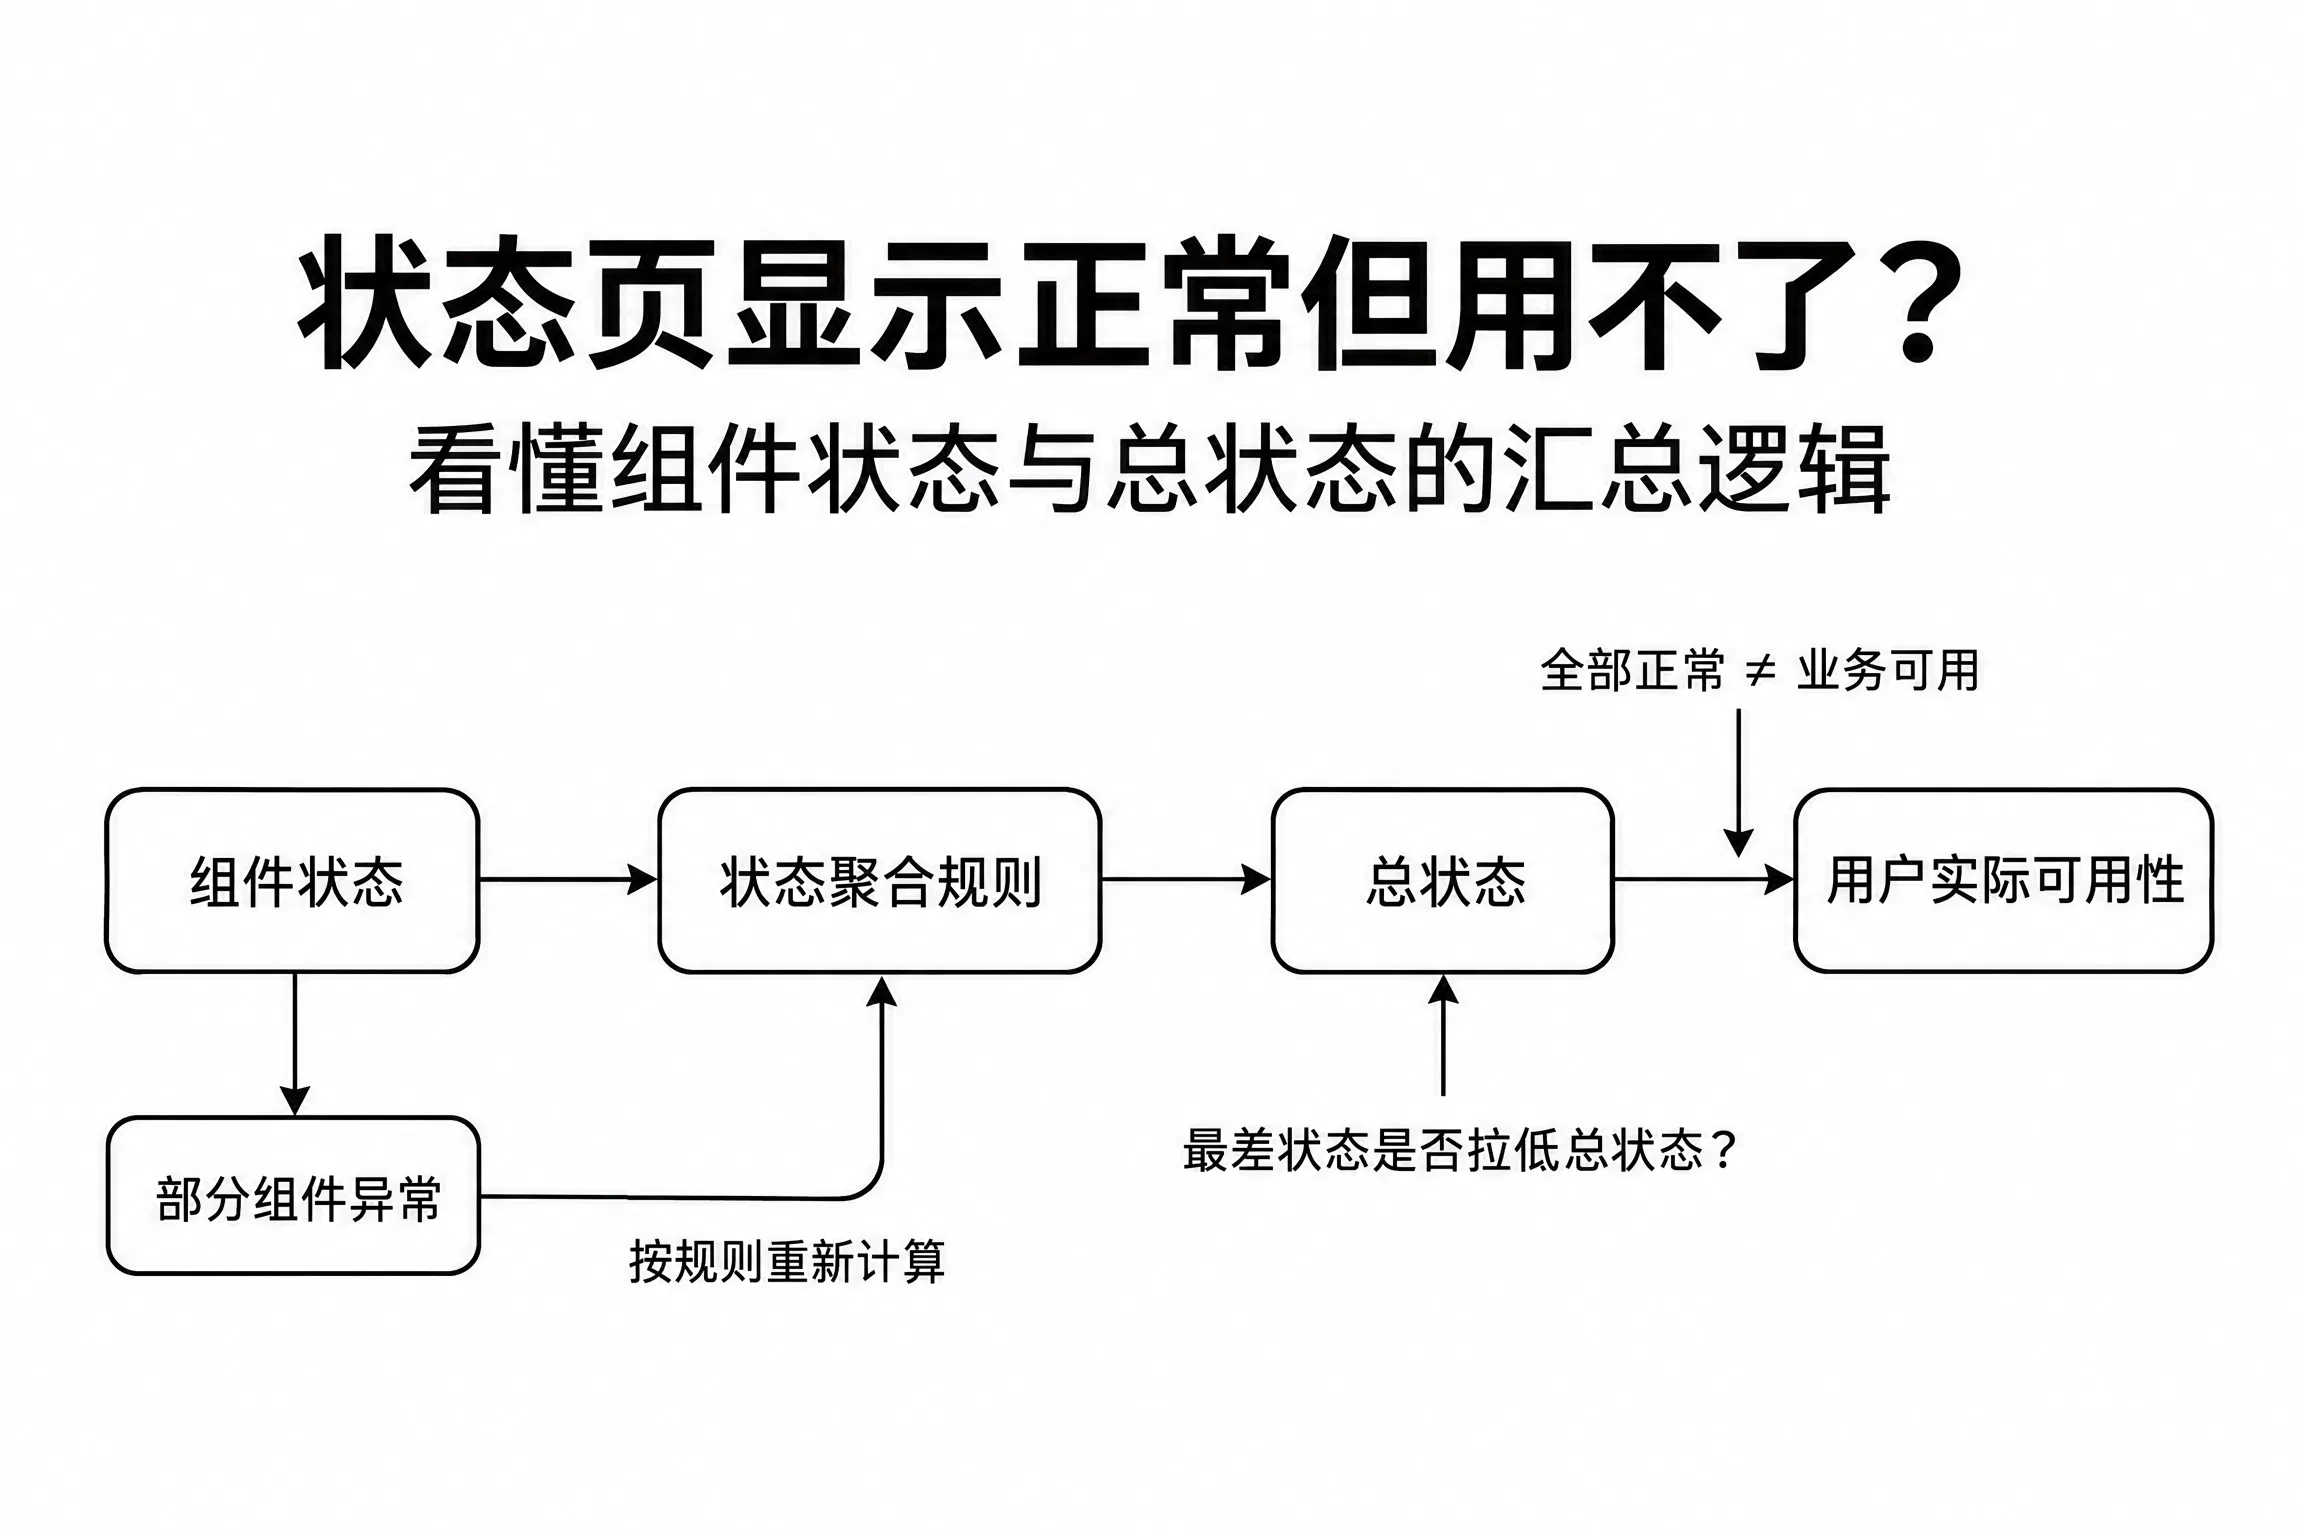
单个组件恢复正常,并不代表整个服务链路畅通。局部观察范围往往无法覆盖总体状态 [1]。这就好比修好了路灯的灯泡,但整条街道的供电线路依然短路,灯还是亮不起来。Azure 维护机制强调必须识别具体受影响的资源,而非仅盯着技术层面的修复动作 [2]。
这里有一个常被外行误解的细节:很多人以为“修复”就是代码回滚或服务器重启完成的那一刻。实际上,在分布式系统中,配置变更的生效往往存在“时间差”和“传播延迟”。工程师可能已经提交了回滚指令,但全球各地的边缘节点(Edge Nodes)还在缓存旧的错误配置,或者负载均衡器尚未将流量完全切回到健康实例上。这种“静默期”里,后台操作已完成,但前端用户依然处于故障窗口中。SRE 流程要求持续记录缓解和恢复的全过程,这意味着“修复”只是起点,而非终点 [3]。若官方缺少监控信号或用户验证步骤,就可能提前发布“完全恢复”公告。此时,系统后台虽已无报错,但前端业务逻辑可能仍被旧数据阻塞,导致用户继续受阻。
现有规范并未规定统一的验证阈值,也未提供大量“公告后仍受影响”的具体案例作为警示 [4]。因此,服务恢复确认流程本应清晰说明验证对象、监控信号、观察窗口及用户需配合的行动。但在缺乏这些细节时,简单的“已恢复”标签容易掩盖真实的等待成本。真正的恢复,需要独立的确认机制来支撑,而非仅靠一次技术操作就宣告结束。
真正的服务恢复需要经历哪四个关键节点
成熟体系中的服务恢复需跨越执行修复、指标达标、抽样验证和观察结束四个节点,缺一不可才能确保业务真正可用。
你刚收到“已修复”的通知,但刷新页面依然报错。问题不在代码没写对,而在官方跳过了中间的确认环节。在 Google SRE 等成熟体系中,从技术动作完成到用户侧感知恢复,中间隔着四道必须跨过的关卡 [2]。这四步并非所有平台都严格执行,却是判断系统维护状态的核心标尺。
第一层:技术动作的完成度
修复措施执行完毕只是起点。工程师可能已经回滚了配置或重启了容器,但这仅代表“操作指令已下达”,不代表系统状态已改变。就像修好水管阀门,不代表水立刻就能流进千家万户。这一步只解决了“做了什么”,还没解决“效果如何”。
第二层:数据指标的达标率
技术动作完成后,监控仪表盘上的数值必须回归正常区间。如果错误率下降、延迟缩短,说明系统内部逻辑已自愈。这是数据层面的硬指标,能过滤掉那些“表面修复、实则故障”的情况。若指标未达标,任何业务验证都是徒劳。
第三层:业务场景的抽样验证
监控数据正常不等于所有功能可用。运维团队需对受影响资源进行抽样或逐项测试,确认核心业务流程(如登录、支付)在实际场景中跑通。这一步将抽象的“指标”转化为具体的“体验”,是区分“系统活了”和“服务好了”的关键分水岭。
值得注意的是,这里的“抽样验证”往往容易被简化为自动化脚本的通过。 许多团队误以为只要核心接口的 HTTP 200 状态码返回,就算验证通过。然而,自动化脚本通常走的是“理想路径”,它可能绕过了复杂的业务逻辑分支。例如,一个支付接口可能通过了健康检查,但用户尝试使用优惠券支付时,由于数据库中的库存锁未释放,依然会失败。这种“脚本通过但真人受阻”的盲区,正是业务验证环节存在的意义——它必须模拟真实用户的非标准操作,而不仅仅是机器发出的标准请求。
第四层:观察窗口的稳定性
最后,系统需在一段时间内持续稳定运行,才能关闭事件并宣布彻底恢复。这不仅是防止故障复发的缓冲期,更是为了捕捉偶发性异常。只有跨过这个时间窗口,官方才有底气发出“完全恢复”的结论。
这四个节点环环相扣,缺一不可。跳过前两步直接喊“好了”,往往是因为缺乏客观数据支撑;忽略后两步则容易陷入“局部修复、全局瘫痪”的陷阱。
| 节点层级 | 关注焦点 | 典型信号 | 缺失后果 |
|---|---|---|---|
| 技术执行 | 动作完成 | 日志显示部署成功 | 误判修复进度 |
| 指标恢复 | 数据达标 | 错误率/延迟回落 | 掩盖潜在风险 |
| 业务验证 | 流程通畅 | 核心功能测试通过 | 局部可用,整体不可用 |
| 观察结束 | 长期稳定 | 持续无新告警 | 故障复发率高 |
Google SRE 体系强调,事件处理的目标始终是减轻影响或恢复服务,因此必须持续记录调试与缓解过程,而非急于发布结论 [3][4]。当官方公告仅提及“已修复”却未展示上述四层证据时,你看到的往往只是技术团队的“自嗨”,而非用户视角的“真恢复”。
如何判断官方公告是否可信:警惕缺失的验证环节
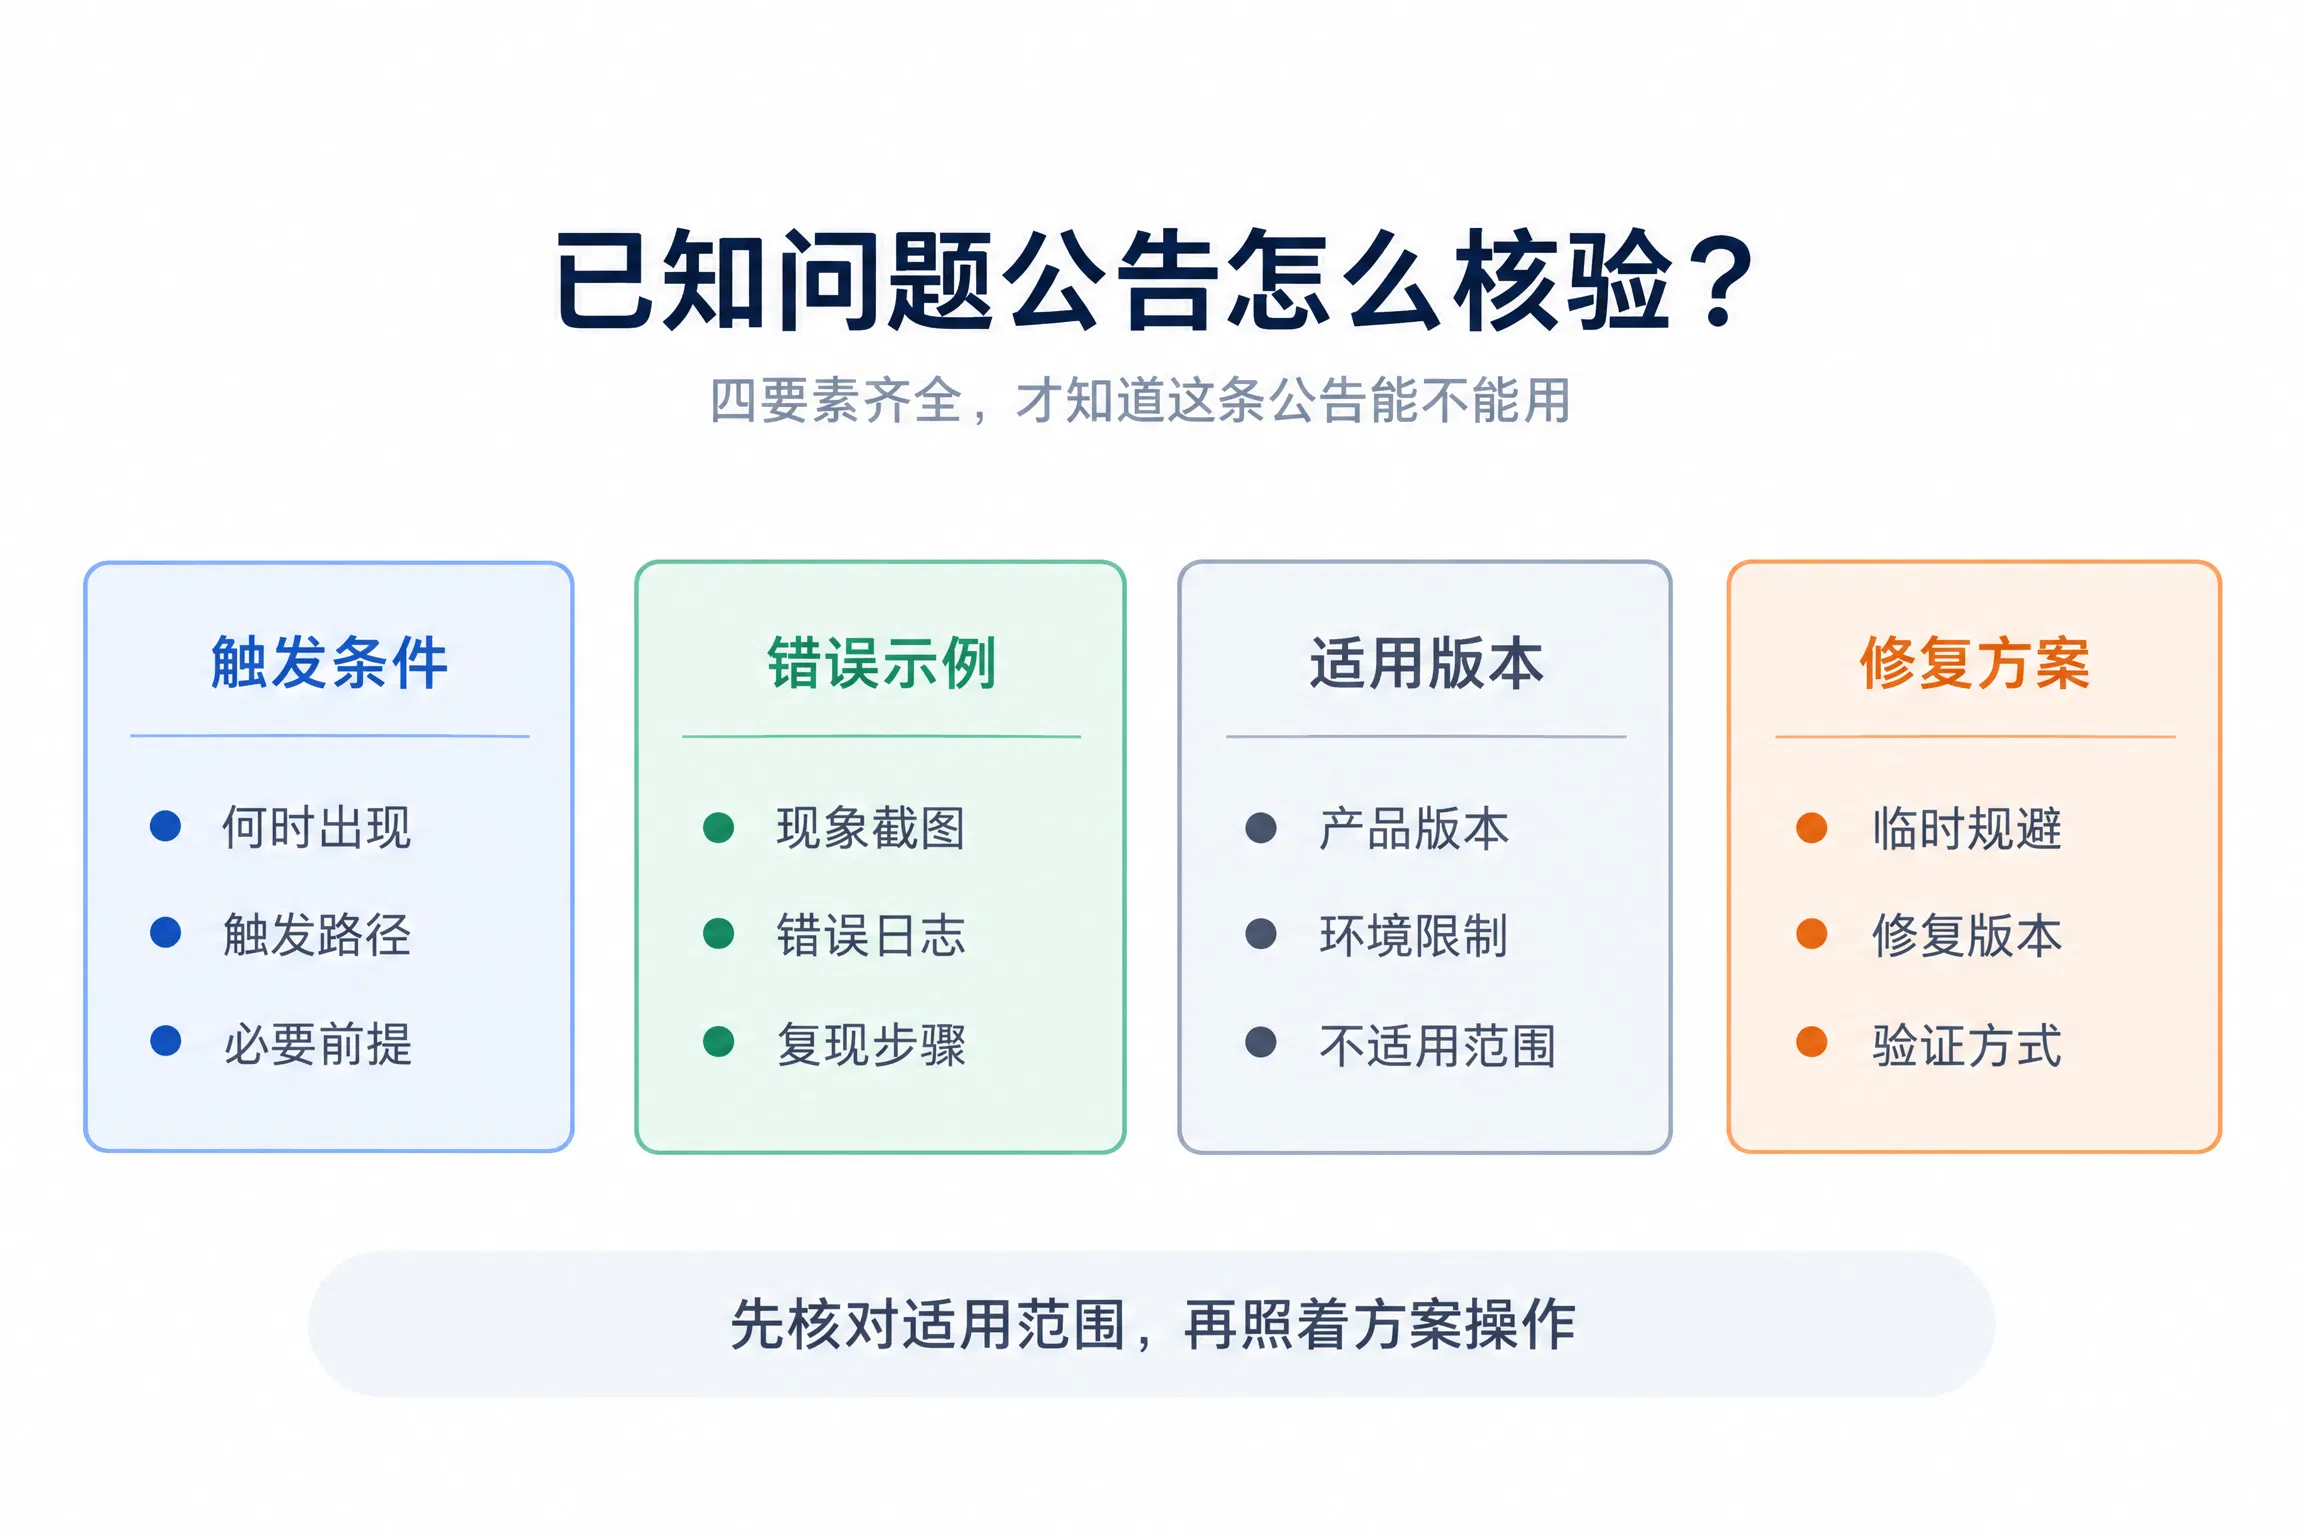
可信的恢复公告必须明确验证对象、监控信号、观察时长及用户动作,缺失任一环节都可能导致局部确认被误判为完全恢复。
你刚收到“服务已恢复”的通知,但登录依然失败。问题往往出在公告本身不够严谨。合格的恢复声明必须交代清楚四件事:验证对象是谁、监控信号是否达标、观察窗口有多长、用户需要做什么。缺少任何一环,所谓的“完全恢复”都可能只是技术层面的局部确认。[1]
很多故障处理流程只关注“修复措施已执行”,却忽略了业务影响是否真正消失。Google SRE 体系要求建立清晰的指挥线,并持续记录调试与缓解过程,以此作为评估依据。[2][3] 但这并不意味着只要代码部署完成,所有用户都能立刻恢复正常。组件状态计算显示,局部组件的修复并不等同于整体服务的可用。[4]
为了看清这种差异,我们可以对比两种常见的公告写法:
| 维度 | 可信度高的公告 | 需警惕的公告 |
|---|---|---|
| 验证对象 | 明确列出核心接口或受影响资源 | 仅提及“系统已升级”或模糊表述 |
| 监控信号 | 展示关键指标(如错误率、延迟)回归正常 | 未提供具体数据支撑 |
| 观察窗口 | 说明仍需持续观察一段时间 | 直接宣布事件关闭,无后续计划 |
| 用户行动 | 提示可能需要清除缓存或重新登录 | 暗示无需任何操作即可使用 |
这里可以引入一个更具体的实操建议: 如果你发现官方公告中没有提及“观察窗口”或“验证对象”,你可以尝试手动触发一个非核心的业务动作(比如点击一下“关于我们”页面,或者尝试搜索一个冷门关键词),然后立即查看浏览器的开发者工具网络面板。如果页面加载速度明显慢于平时,或者出现了大量的 304 Not Modified 响应,这通常意味着 CDN 缓存尚未更新,或者后端服务仍在向旧版本节点转发流量。这种情况下,即使官方宣称“已恢复”,你也应该保持耐心,不要反复刷新导致账号被限流。
若服务方只能确认其中部分节点,比如只完成了代码部署,却宣称“完全恢复”,用户很可能继续受阻。现有资料并未规定统一的验证阈值,也未收录大量“公告后仍受影响”的具体案例,这反而增加了盲目信任的风险。[1]
面对这种情况,最稳妥的策略是保持“监控中”的心态。不要轻信无条件宣告的“完全恢复”,除非对方明确展示了从技术执行到业务验证的完整闭环。只有当四个关键节点全部到位,服务恢复确认流程才具有真正的可信度。
面对“假恢复”现象,用户该如何应对
面对假恢复现象,用户应警惕缺乏统一验证阈值的单一公告,需结合多步确认机制与自身实际体验判断系统真实状态。
官方宣布修复后服务依旧不可用,核心在于缺乏统一的验证阈值。现有规范强调多步确认,而非单一信号 [1]。当组件状态与整体业务表现存在观察范围差异时,盲目信任“已恢复”公告极易误判 [2]。
在观察窗口内,保持“监控中”的心态比急于操作更稳妥。不要只盯着一条通知,应通过多渠道交叉验证服务状态。Google SRE 体系建议尽早且频繁沟通,建立明确的角色分工,这些动作为用户提供了判断依据 [3][4]。若公告未说明具体的监控指标或观察时长,其可信度便存疑。
只有走完四节点流程——从执行修复、指标回升、抽样验证到观察结束,才能真正解决“收到恢复通知后为什么服务还没好”的困惑 [1]。在此之前,任何单点确认都可能是局部正常的假象。理解系统维护状态判断的逻辑,能让你在等待中不再焦虑。
常见问题 (FAQ)
Q: 为什么官方说“已修复”但我还是打不开网页?A: 这通常是因为官方只完成了技术层面的修复(第一层),尚未完成业务验证和观察窗口(第三、四层)。请查看是否有详细的验证报告,若无,建议稍后再试或联系支持。
Q: 如何快速判断一个恢复公告是否靠谱?A: 寻找公告中是否包含具体的监控指标变化(如错误率下降)、明确的观察时长以及是否需要用户配合(如清除缓存)。如果只有一句“系统已恢复”,大概率是不完整的。
Q: “服务恢复确认流程”通常需要多久?A: 根据故障复杂度不同,完整的四节点流程可能需要数小时甚至更久。关键在于最后一步“观察窗口”的稳定性,这是防止故障复发的关键。
参考来源
Top-level status and incident impact calculations | Statuspage | Atlassian Support · https://help.statuspage.io/help/component-status-incident-impact-and-top-level-status-calculations(A级)
Google SRE - Root Cause Analysis for Probing Incident · https://sre.google/workbook/incident-response/(A级)
Google SRE - Incident Management: Key to Restore Operations · https://sre.google/sre-book/managing-incidents/(A级)
维护通知 - Azure Virtual Machines | Microsoft Learn · https://learn.microsoft.com/zh-cn/azure/virtual-machines/maintenance-notifications(A级)